Lucyware.AI
레거시 DB와 문서 자산을 온톨로지 기반 지식 모델로 재구성해, 근거를 추적할 수 있는 엔터프라이즈 RAG 를 만드는 지식 인텔리전스 플랫폼입니다.
무엇인가
Lucyware.AI 는 파편화된 기업의 레거시(Legacy) DB와 다양한 문서 자산을 온톨로지(Ontology) 기반의 지식 모델로 재구성하여, 고성능·고신뢰성 엔터프라이즈 RAG(Retrieval-Augmented Generation) 시스템을 구축하는 지식 인텔리전스 플랫폼입니다.
기존 벡터(Vector) 단독 기반 RAG 에는 고유한 한계가 있습니다 — 맥락 상실, 환각(Hallucination), 정형·비정형 데이터 간 연계성 부족입니다. 이를 해결하기 위해 기업 고유의 비즈니스 로직과 엔티티 간 관계(Relationship)를 다차원적 데이터 마트로 구조화하는 것이 핵심 메커니즘입니다.
현업과 데이터 사이의 거리
데이터는 있는데 묻는 방법이 없습니다. 숫자 하나를 확인하려면 요청서를 쓰고 담당자가 SQL 을 짜고 며칠을 기다립니다. 그 사이 판단은 감으로 내려집니다.
Lucyware.AI 는 그 거리를 없앱니다. 현업이 쓰던 말 그대로 묻고, 어떤 테이블을 어떻게 읽어 나온 숫자인지를 답과 함께 봅니다. 근거가 보이지 않는 답은 검증할 수 없고, 검증할 수 없는 답은 업무에 쓸 수 없습니다.
전체 구조
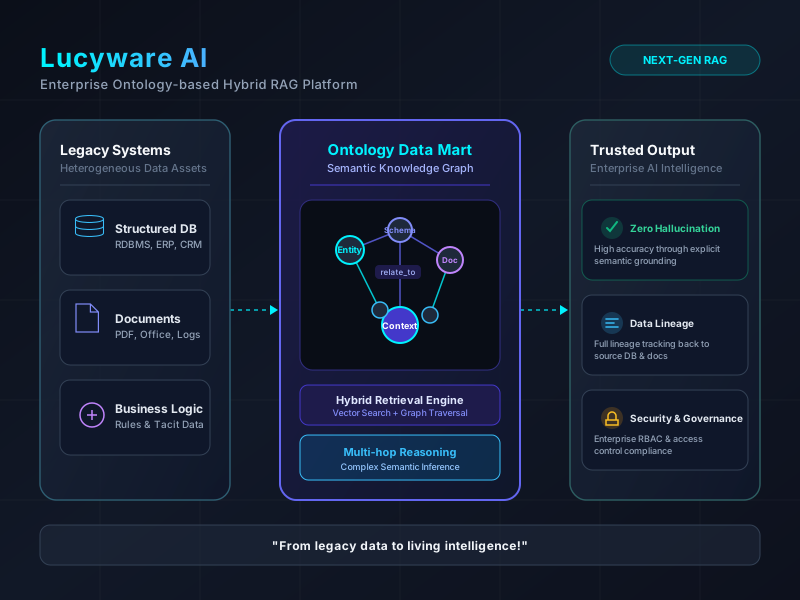
레거시에서 지식으로, 지식에서 검증된 답으로 가는 길입니다.
핵심 기술
벡터 검색 하나로는 닿지 않는 자리를 온톨로지가 메웁니다.
시맨틱 레거시 데이터 파이프라인
RDBMS·NoSQL·ERP/CRM 등 이종의 레거시 DB와 PDF·Office 문서 같은 비정형 데이터를 수집하고, 데이터 간의 매핑을 통해 의미론적(Semantic) 구조로 자동 가공합니다.
온톨로지 기반 지식 그래프 데이터 마트
엔티티(Entity)·속성(Attribute)·관계성(Relationship)을 명시적으로 정의한 도메인 특화 데이터 마트를 구축합니다. 단순 임베딩이 아니라 의미론적 추론(Reasoning)이 가능한 기반이 됩니다.
하이브리드 RAG 엔진
고차원 벡터 유사도 검색(Dense Retrieval)과 온톨로지 그래프 탐색(Graph Traversal)을 결합합니다. 단편적 검색으로는 풀기 어려운 복잡한 다단계 질문(Multi-hop Query)에 정확한 맥락을 제공합니다.
추적 가능성과 거버넌스
생성된 답변의 근거가 되는 레거시 데이터와 문서의 정확한 출처(Data Lineage)를 제공하며, 기존 기업 보안 체계 및 역할 기반 권한 제어(RBAC)와 연동됩니다.
일반 Vector RAG 와 무엇이 다른가
| 구분 | 일반 Vector 기반 RAG | Lucyware.AI (온톨로지 기반 RAG) |
|---|---|---|
| 데이터 구조화 | 단순 텍스트 청킹(Chunking) 및 벡터화 | 비즈니스 로직을 반영한 온톨로지 데이터 마트 구성 |
| 맥락 이해도 | 단어 간 수학적 유사도 기반 — 단편적 정보 | 엔티티 간 연관 관계 추론 기반 — 구조적·맥락적 정보 |
| 복잡 질의 대응 | 연관 데이터를 통합 탐색할 때 정보 유실이 생김 | 지식 그래프 탐색을 통한 정확한 연계 답변 |
| 신뢰성과 출처 | 환각 위험이 있고 출처 검증이 제한적 | 데이터 리니지(Lineage) 기반의 높은 투명성과 검증 가능성 |
무엇을 하는가
자연어 질의
「지난 분기 거래처별 매출」 처럼 업무의 말로 묻습니다. SQL 을 배우지 않아도 됩니다.
근거가 붙은 답
실행된 질의와 참조한 테이블을 함께 보여줍니다. 답을 믿을지 사람이 판단할 수 있습니다.
권한을 넘지 않는 답
계정이 원래 볼 수 있는 범위 안에서만 답합니다. AI 를 통했다고 더 보이면 안 됩니다.
읽기 전용이 기본
질의는 조회로 제한합니다. 데이터를 바꾸는 일은 사람이 결재하는 경로로만 갑니다.
문서와 데이터를 함께
규정·매뉴얼 같은 문서도 같은 창구에서 찾습니다. 답의 출처가 표인지 문서인지 구분해 보여줍니다.
내부 설치 선택
데이터를 밖으로 내보내기 어려운 곳을 위해 사내망 구성과 자체 모델 운영을 지원합니다.
도입하면 무엇이 달라지는가
수십 년 쌓인 암묵지의 자산화
레거시 시스템에 방치되어 있던 대용량 DB와 문서 데이터를 인공지능이 바로 활용할 수 있는 지식 자산으로 전환합니다.
환각 없는 답변 정확도
복잡한 산업 도메인 특화 데이터에 대한 질문에도 환각 없는 고품질 답변을 만듭니다.
다시 만들지 않는 확장
사업 영역이 넓어져도 온톨로지 스키마와 마트 레이어를 고치는 것으로 확장합니다.
MetaDRAG® 를 바탕으로 동작합니다
온톨로지를 세우려면 먼저 지금 있는 데이터가 무엇인지 알아야 합니다. 그 바탕이 MetaDRAG® 가 정리한 메타데이터입니다. 스키마를 모른 채 학습한 모델이 이름을 추측하는 것과, 정리된 구조를 읽고 질의를 조립하는 것은 결과가 다릅니다.
도입을 검토하고 계신가요?
데이터 현황을 함께 살펴보고 PoC 범위를 제안해 드립니다. 먼저 무엇을 풀어야 하는지부터 이야기해 주세요.